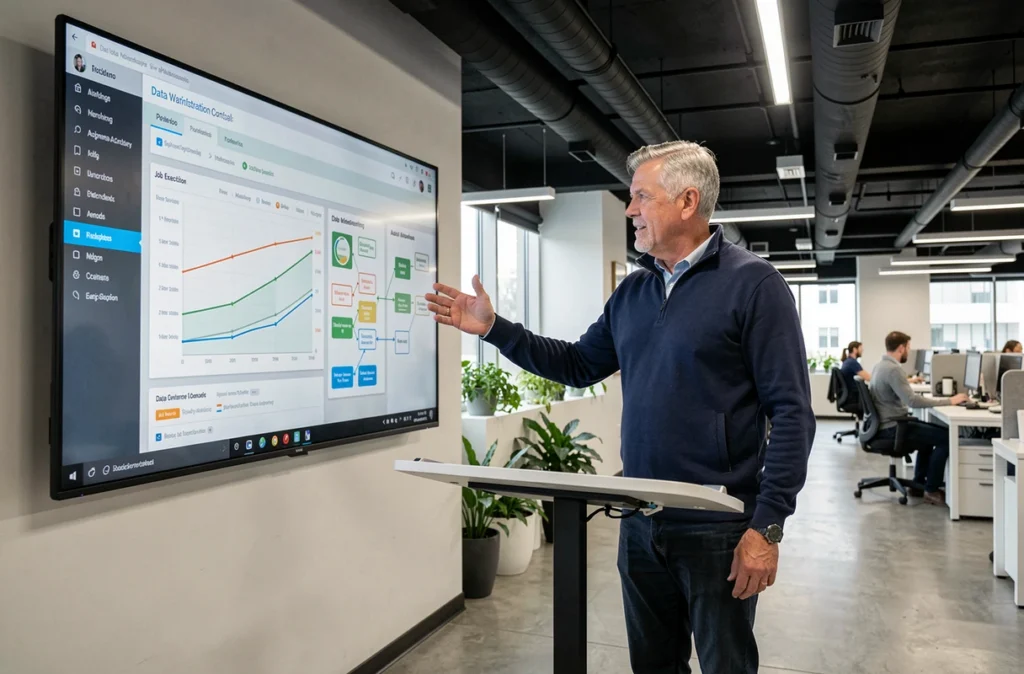
La Data Warehouse Administration Console n’est pas un tableau de bord de plus : c’est l’interface depuis laquelle un administrateur pilote l’ensemble du cycle de vie des données, du chargement initial jusqu’à la disponibilité analytique. Son efficacité repose sur des choix d’architecture précis, une organisation rigoureuse des jobs et une capacité de monitoring qui va bien au-delà de la simple vérification d’un statut « succès » ou « échec ».
Distinguer une panne d’un chargement incomplet dans la console d’administration
C’est le problème central que toute console d’administration sérieuse doit résoudre : un job terminé avec le statut « succès » peut tout aussi bien masquer un chargement partiel, des données périmées ou un volume anormalement bas. Un statut vert ne garantit pas la fraîcheur ni la complétude des données.
Pour rendre ce diagnostic exploitable, la console doit exposer au minimum quatre signaux distincts pour chaque job de chargement : le statut d’exécution technique, le volume de lignes traitées par rapport au volume attendu, l’horodatage de la dernière mise à jour effective de chaque table cible, et les éventuelles alertes de cohérence post-chargement.
Un chargement réussi mais incomplet se détecte par la combinaison d’un delta de volume et d’une comparaison avec la fenêtre temporelle de référence. Sans ces deux indicateurs affichés conjointement, l’administrateur ne peut pas distinguer un traitement nominal d’une ingestion tronquée due à un timeout de connecteur ou à une coupure réseau en milieu de flux.
Piste de diagnostic de la source jusqu’au rapport
La console doit matérialiser le chemin complet : source de données, connecteur d’intégration, zone de staging, tables du data warehouse, puis couches de présentation ou cubes analytiques. Chaque maillon doit porter son propre état, sa dernière date de rafraîchissement et un lien vers les logs détaillés.
Quand une anomalie remonte dans un rapport, l’administrateur doit pouvoir remonter la chaîne en moins de trois clics jusqu’à la source défaillante. Sans cette traçabilité de bout en bout, la recherche de cause racine se transforme en investigation manuelle sur plusieurs systèmes, ce qui rallonge considérablement le temps de résolution.
Architecture interne de la console : composants et responsabilités
Une console d’administration de data warehouse structure ses fonctionnalités autour de trois couches fonctionnelles qui ne doivent pas être confondues même si elles cohabitent dans la même interface.
- Couche de pilotage des jobs : ordonnancement, déclenchement manuel ou automatique, gestion des dépendances entre traitements. C’est ici que se configurent les chaînes ETL/ELT, les fenêtres de chargement et les stratégies de reprise sur erreur.
- Couche de surveillance opérationnelle : métriques en temps réel sur les temps d’exécution, les volumes traités, la charge des ressources de calcul et de stockage. Elle alimente les alertes et les seuils d’anomalie.
- Couche de qualité et de cohérence des données : contrôles post-chargement automatisés, règles de validation sur les colonnes critiques, suivi de la fraîcheur par domaine métier. C’est la couche la plus souvent absente dans les consoles basiques.
La séparation claire de ces responsabilités permet d’affecter des droits d’accès granulaires : un opérateur de nuit surveille et redémarre des jobs sans pouvoir modifier les règles de qualité, tandis qu’un data engineer accède à la configuration complète.
Gestion des dépendances entre jobs
Dans un entrepôt de données mature, les jobs ne s’exécutent pas de façon indépendante. Un job de chargement de faits dépend de la complétion des dimensions, qui dépendent elles-mêmes de sources multiples avec des délais de disponibilité variables.
La console doit afficher ces dépendances sous forme de graphe orienté, avec l’état de chaque noeud. Un job en attente doit indiquer explicitement pourquoi il attend, et non rester dans un statut « pending » opaque. C’est ce niveau de détail qui rend la gestion des incidents nocturnes supportable sans escalade systématique.
Monitoring de la fraîcheur et des volumes : les bons indicateurs dans l’administration quotidienne
La surveillance des jobs d’exécution ne suffit pas à garantir la qualité du data warehouse. La fraîcheur, le volume et la complétude sont des indicateurs opérationnels à part entière.
Pour chaque domaine de données, l’administrateur doit définir un SLA de fraîcheur : délai maximal acceptable entre la mise à jour de la source et la disponibilité dans l’entrepôt. La console compare en continu la date de dernière mise à jour effective avec ce seuil et déclenche une alerte si l’écart est dépassé, même en l’absence de toute erreur technique.
Le suivi des volumes fonctionne sur le même principe : un profil de volume attendu par période (heure, jour, semaine) sert de référence. Un volume inférieur à la fourchette normale déclenche une alerte de type « données incomplètes » distincte des alertes d’erreur technique. Cette distinction est fondamentale pour le tri des incidents.
Alertes exploitables versus bruit de monitoring
Une console qui génère trop d’alertes redondantes ou trop peu précises finit par être ignorée. Chaque alerte doit indiquer le composant affecté, le type de problème (panne, retard, volume anormal, cohérence dégradée), la gravité et l’action attendue.
Les alertes groupées par cause racine évitent le phénomène de tempête d’alertes : quand un connecteur source tombe, ce n’est pas vingt alertes sur vingt tables qui doivent remonter, mais une seule alerte sur le connecteur avec la liste des impacts en cascade.
Rôles et accès : structurer les droits dans la console
L’administration quotidienne d’un data warehouse implique plusieurs profils aux besoins distincts. Confondre leurs périmètres dans la console crée des risques opérationnels et de sécurité.
- Administrateur de plateforme : accès complet à la configuration, aux connexions aux sources, aux ressources de calcul et aux paramétrages de sécurité. Ce rôle modifie l’architecture.
- Opérateur de traitement : surveille les jobs, redémarre les traitements en erreur, consulte les logs. Ne touche pas à la configuration.
- Data steward : accède aux rapports de qualité des données, configure les règles de validation, valide les anomalies de cohérence. N’a pas accès aux logs techniques d’infrastructure.
- Analyste BI : consulte les métriques de disponibilité et de fraîcheur des données qui l’intéressent, sans accès aux paramétrages de la console.
Cette séparation se traduit dans la console par des vues filtrées : chaque profil voit uniquement ce qu’il doit voir, avec des actions limitées à son périmètre. La documentation des droits accordés doit être traçable et auditée régulièrement.
Documentation intégrée à la console
La documentation technique d’un data warehouse se périme vite si elle vit dans un outil séparé. Les consoles les plus efficaces intègrent directement dans chaque composant (job, connecteur, table) un champ de documentation éditable, l’historique des modifications de configuration et les liens vers les tickets d’incident associés. Cette traçabilité intégrée réduit le temps d’onboarding des nouveaux administrateurs et fiabilise la gestion des changements.
Un changement de paramètre de connecteur sans documentation associée est une dette opérationnelle qui se paie lors du prochain incident nocturne. Rendre la documentation obligatoire à la sauvegarde de tout changement de configuration est une contrainte rentable sur le long terme.